多 Agent 协作模式 · MA-05
生成-评审循环
写手写 → 评审员打分 → 不达标就带着意见重写,最多改 2 轮:Evaluator–Optimizer
系统架构
上面的图是协作流程:谁把什么交给谁。这张图是把它真正跑起来需要的组件:共享状态、通信通道、隔离和闸门。
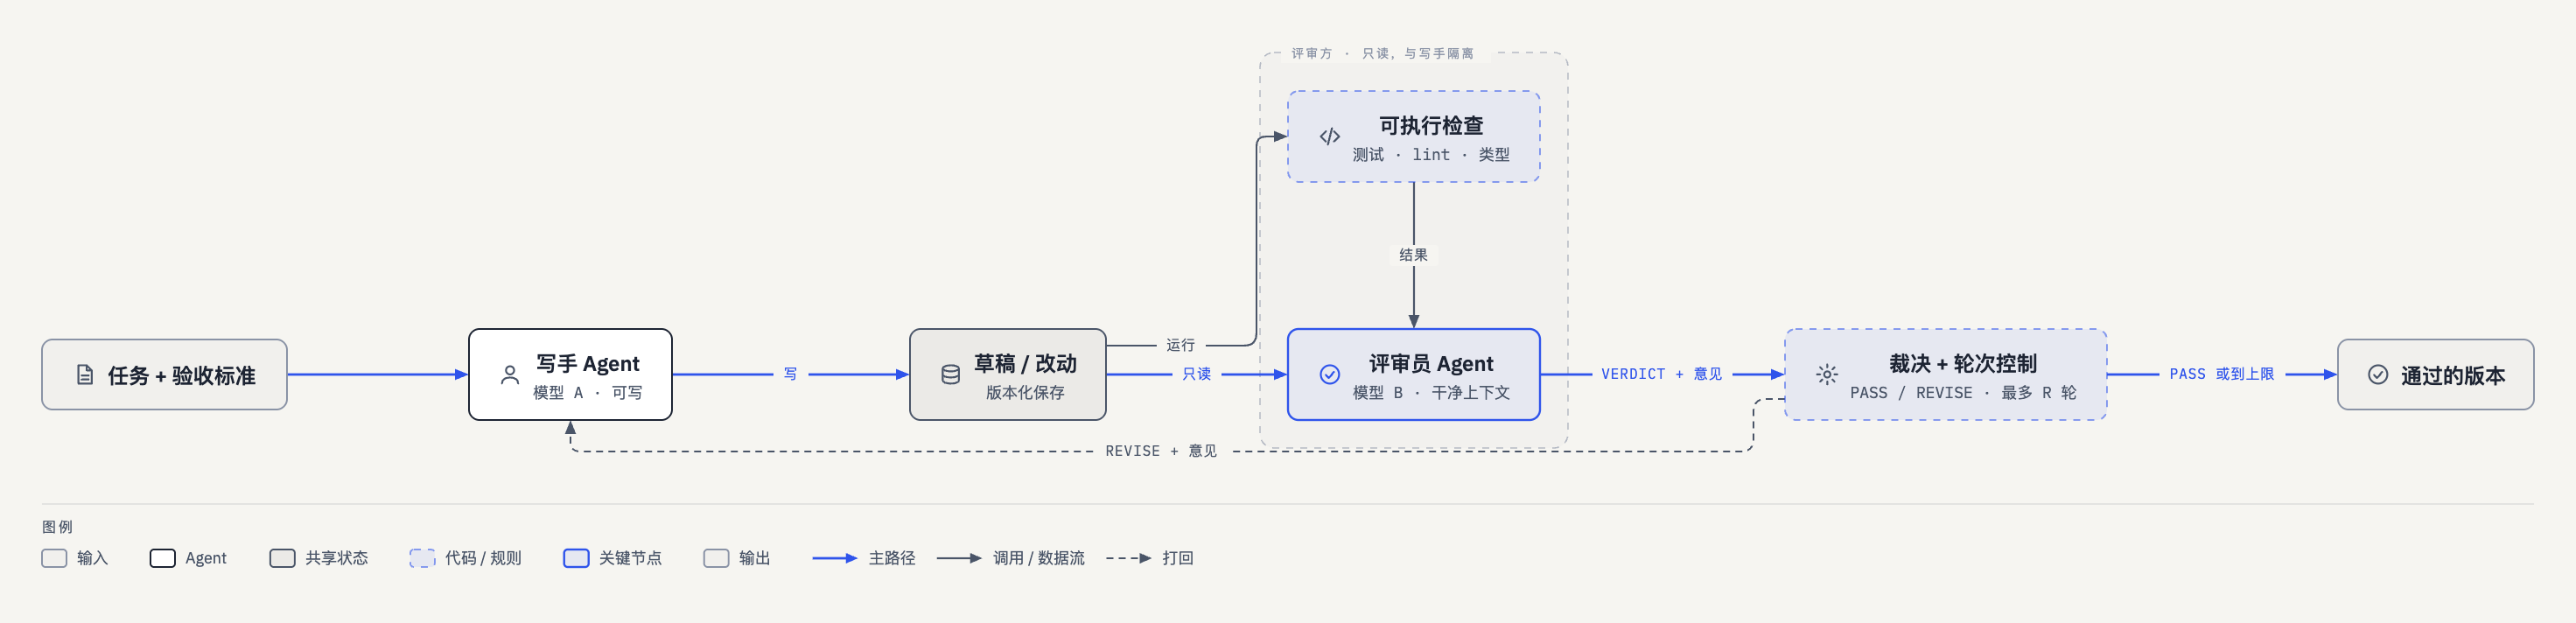
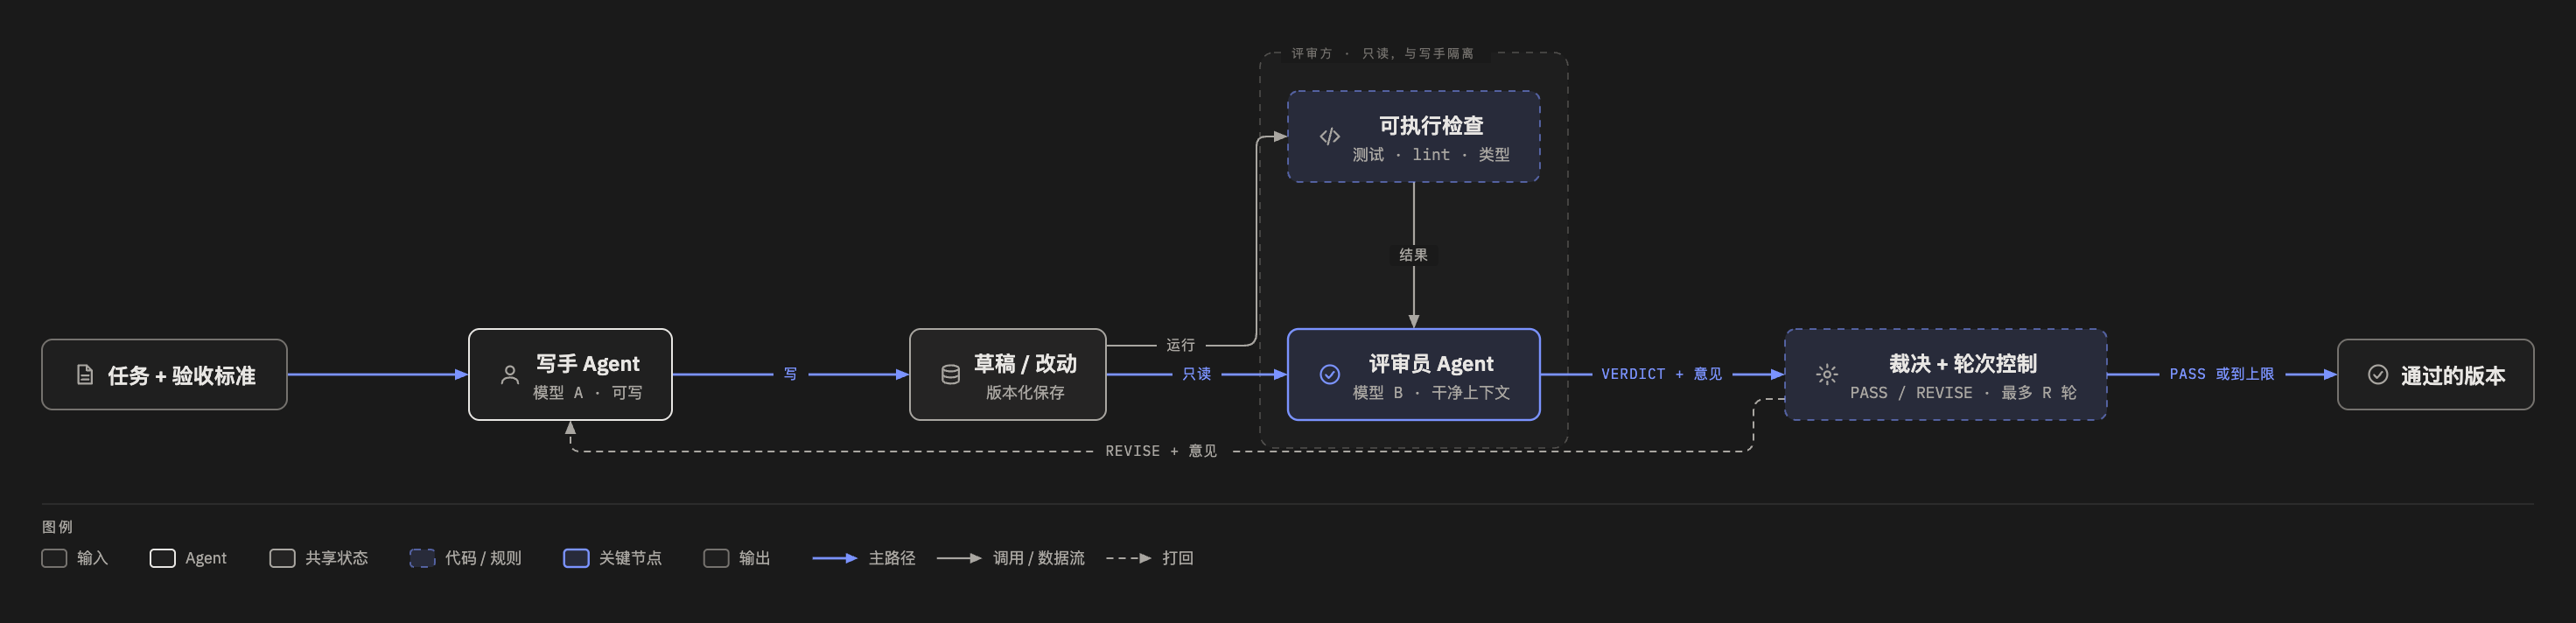 打开可交互的架构图 →
优势与劣势
+ 优势
- 质量逐轮提升,有明确的验收标准
- 评审员更强、上下文干净时提升明显(Codex 写、Claude 审:71.6% → 89.7%)
- 结构简单,容易加到现有流程上
适合:对质量要求高的单件产出;有客观标准的任务(代码、测试、格式)
- 劣势
- 标准偏松等于没审,偏严会一直打回、烧钱
- 每多一轮就多一段串行等待,成本也随轮数增加
- 评审员比写手弱时会帮倒忙(Claude 写、Codex 审:91.4% → 82.8%)
- 评审员和写手同一家时,错误往往相关,盲点也相同
不适合:没法给出评审标准的任务;对延迟敏感的场景
- 模型调用
- 2 ~ 2R + 1
- 串行轮数
- 2 ~ 2R + 1
- 耗时取决于
- (写 + 评)× 轮数
- 并行
- 无
- 成员之间
- 写手能看到评审意见
- 质量检查
- 独立评审员按标准打分,不达标打回
- 返工
- 最多 R 轮
市面上遵循此模式的工具
2026-11-06 对照官方文档和仓库核实。多数只是"部分对应":核心机制属于这种模式,不代表实现了图上的每个节点;标"实验""预览"的是厂商尚未正式发布的功能。
- 插件Claude Code + Codexcodex-plugin-cc 可选评审闸门
- 厂商Claude CodeStop hook 退出码 2 打回
- 第三方Orchestrator.incCI / 评审意见推回 worker
- 框架Google ADKLoopAgent
- 框架OpenAI Agents SDKllm_as_a_judge 示例